“매주 새 자료를 조사해서 블로그 초안을 만들고, 내가 정한 기준에 맞으면 게시해 줘.” 이 일을 맡기려면 문장을 잘 생성하는 모델만으로는 부족합니다. 지난 작업을 기억하고, 브라우저와 파일을 다루고, 다음 실행 시간을 등록하고, 게시 권한을 확인하는 실행 시스템이 필요합니다.
Dots·Muse·OpenClaw·Hermes를 이해하려면 요청이 어디서 실행되고, 어떤 기억을 읽으며, 도구 결과가 어떻게 다음 행동으로 이어지는지를 봐야 합니다. Dots와 Muse는 이런 환경을 서비스로 제공하고, OpenClaw와 Hermes는 사용자가 실행 환경과 모델 연결을 구성할 수 있는 오픈소스 에이전트입니다. 다만 네 제품 모두 도구·기억·자동화가 겹칩니다. 어느 한쪽에만 있는 기능처럼 나누면 실제 구조를 놓칩니다.
공식 자료 확인: 2026년 10월 7일. 공개 문서와 코드의 구조를 설명한 글이며, 네 제품에 동일 과제를 실행한 성능 실험은 아닙니다.
1. 공통 원리: 판단 → 도구 실행 → 결과 관찰
에이전트의 기본 동작은 반복입니다. 모델이 요청을 읽고 다음 행동을 고르면, 실행 프로그램이 실제 도구를 호출합니다. 검색 결과, 명령 실행 로그, 파일 내용 같은 관찰 결과를 모델에 돌려주고, 모델은 이를 보고 다음 행동이나 완료 여부를 판단합니다. 처음 세운 계획을 그대로 실행하는 고정 매크로와 달리, 중간 결과에 따라 경로가 바뀔 수 있습니다.
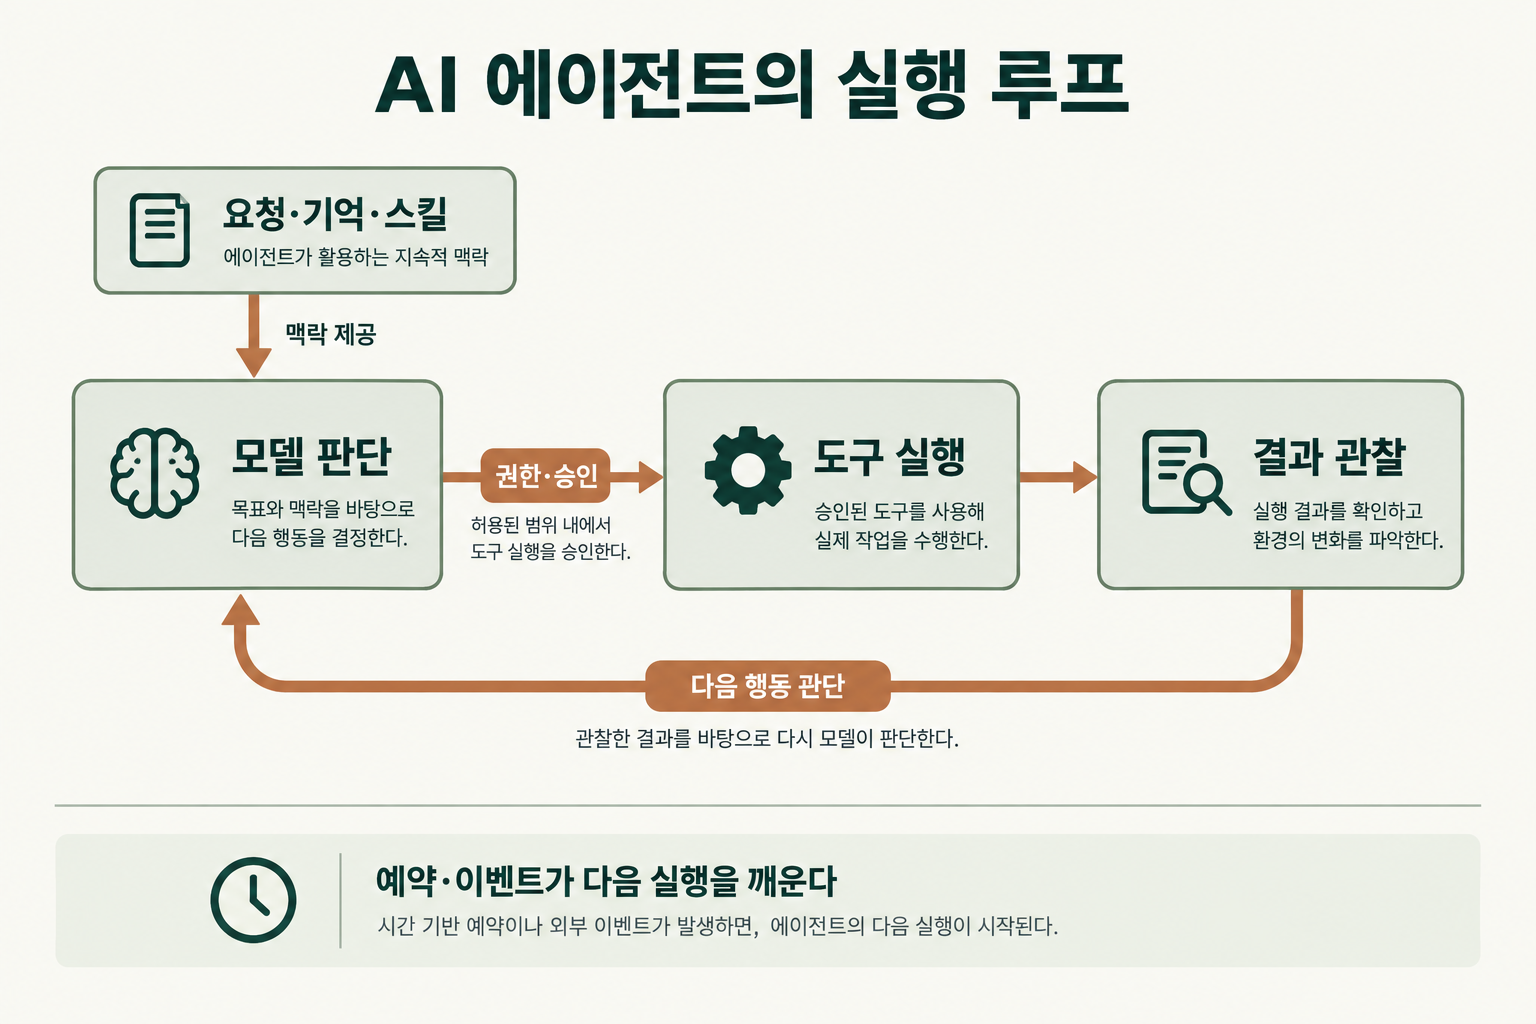
이 반복을 관리하는 프로그램을 하네스 또는 런타임이라고 부릅니다. 실행기는 대화 기록을 구성하고, 사용 가능한 도구를 알려 주며, 도구 호출과 오류 처리를 담당합니다. 기억은 다음 실행에 다시 넣을 정보이고, 스킬은 특정 일을 처리하는 절차·참고 자료입니다. 스케줄러는 정해진 시각이나 조건에 실행을 시작합니다. 모델의 추론 능력과 이 실행 구조가 함께 결과를 만듭니다.
지속성에는 세 가지가 있습니다. 현재 작업을 여러 단계로 이어 가는 것, 끝난 세션의 정보를 다음 세션에서 꺼내는 것, 나중에 새 작업을 시작하는 것입니다. 긴 대화창 하나를 열어 두는 것만으로 이 세 가지가 모두 해결되지는 않습니다.
2. Dots: 클라우드 컴퓨터에서 이어지는 위임 작업
요청을 받은 뒤 무엇이 움직이나
OpenAI의 Dots는 GPT‑6 Astra를 바탕으로, 각 dot에 전용 클라우드 컴퓨터와 브라우저를 제공하는 개인 에이전트 서비스입니다. 사용자는 ChatGPT 등 지원되는 대화 창구로 요청하고, dot은 연결된 서비스와 자기 컴퓨터의 파일·코드·브라우저를 이용해 작업합니다. 필요에 따라 로컬 컴퓨터 연결도 사용할 수 있습니다.
클라우드 컴퓨터는 자료를 내려받아 가공하고, 코드를 실행하고, 중간 파일을 남길 수 있는 작업 공간입니다. 여러 단계의 작업을 맡긴 뒤에도 진행 상태를 확인하고 방향을 바꿀 수 있습니다. 공개 시스템 카드에는 하위 에이전트에 작업을 위임하는 방식과 시간 예산 설정도 설명되어 있습니다. 시간 예산은 해당 작업에 얼마나 시간을 쓸지 안내하는 실행 조건입니다. 다만 모든 요청을 반드시 같은 수의 하위 작업으로 나눈다는 뜻은 아닙니다.
작업 흐름
사용자의 목표와 기존 맥락 → dot의 작업 진행·필요한 위임 → 도구 사용 제안 → 적용되는 권한 검사 → 클라우드 컴퓨터·연결 서비스 실행 → 결과를 받아 작업 계속
근거: OpenAI의 Dots 소개, GPT‑6 Astra 시스템 카드의 Dots 설명.
기억과 백그라운드 작업을 구분해야 한다
Dots는 설정에 따라 ChatGPT의 기억과 최근 대화 맥락을 전달받고, dot과의 대화도 ChatGPT 기억에 반영될 수 있습니다. dot 자체에도 대화와 연결 서비스에서 얻은 맥락이 남습니다. 따라서 “어제 말한 내 프로젝트를 오늘도 안다”는 동작에는 이런 맥락의 공유·보존이 관여합니다. 확인한 공개 자료만으로 내부 기억을 특정 벡터 데이터베이스나 특정 Markdown 파일 구조라고 단정할 수는 없습니다. Dots 개인정보·안전 FAQ는 공유를 끄는 것과 이미 전달된 맥락을 삭제하는 것도 구분합니다.
백그라운드 동작에도 차이가 있습니다. 사용자가 맡겨 놓은 작업을 계속하는 것과, dot이 도움이 될 정보를 미리 찾아보는 선제적 조사는 별도 경로입니다. 공개된 선제적 조사 경로는 연결된 자료를 읽고 비공개 메모를 만드는 범위로 제한됩니다. 이 조사 자체가 타인에게 메시지를 보내거나 앱 내용을 바꾸거나 브라우저·컴퓨터를 제어할 권한을 얻는 것은 아닙니다.
실제 행동에는 별도의 검사 체계가 있습니다. Dots의 자동 검토 시스템은 검토 대상 행동의 목적과 인자를 사용자의 지시·규칙에 비춰 확인합니다. 허용되면 도구가 실행되고, 거절되면 사유가 돌아와 에이전트가 방식을 바꾸거나 사용자에게 확인하거나 중단할 수 있습니다. 일을 수행하는 에이전트와 행동을 검사하는 계층을 분리하는 구조입니다. 매번 모든 읽기 작업에 같은 확인 창을 띄우는 방식은 아닙니다. OpenAI의 Dots 안전·보안 설계에서 이 구분을 설명합니다.
3. Muse: 개인 VM 안의 실행기와 바깥의 권한 계층
전용 컴퓨터와 모델 추론은 다른 위치에 있다
Meta의 Muse는 Muse Spark를 기반으로 개인별 Secure VM을 제공하는 에이전트입니다. 앱·웹·WhatsApp은 작업을 주고받는 창구이고, 실제 작업은 서비스의 실행 환경에서 계속됩니다. 앱을 닫아도 작업이 이어지는 이유를 휴대전화 안에서 모델이 계속 돌아가기 때문이라고 이해하면 안 됩니다. Meta의 Muse 소개는 전용 VM과 지속 작업을 설명합니다.
Muse의 보안 문서는 이 내부 구조를 비교적 자세히 공개합니다. 핵심 실행기인 Hatch와 작업 파일·도구는 Linux VM 안의 실행용 컨테이너에 놓입니다. 에이전트는 파일 시스템, 터미널, 브라우저로 일을 하지만, 모델 추론은 별도 인프라에서 처리합니다. “내 전용 VM이 있다”와 “모델까지 내 VM 안에서만 돈다”는 다른 설명입니다.
행동을 제안하는 실행기와 허용하는 시스템의 분리
실행용 컨테이너 밖에는 권한을 판단하는 Sentinel, 자격 증명 보관 서비스, 커넥터 실행 구성요소 등이 있습니다. 내장 커넥터를 호출할 때 에이전트가 작업·대상·범위를 제안하면 Sentinel이 사용자 정책에 따라 허용·거절·추가 승인을 결정합니다. 네트워크 외부 통신도 이 권한 체계의 대상입니다.
연결 서비스에 행동하는 흐름
Hatch가 작업 제안 → Sentinel이 정책·승인 확인 → 허용된 실제 요청에 자격 증명 적용 → 연결 서비스 실행 → 결과를 Hatch에 반환
내장 커넥터의 비밀값은 에이전트에게 그대로 건네는 대신 대체 토큰을 사용하고, 실제 요청 경계에서 필요한 자격 증명을 적용합니다. 사용자의 승인이 필요한 경우에는 구조화된 승인 화면을 거쳐 권한 시스템에 전달됩니다. 이런 설계의 의미는 브라우저와 코드를 다루는 에이전트가 자기 권한을 임의로 늘리지 못하도록 실행과 허가의 경계를 두는 데 있습니다. Muse의 보안 아키텍처가 해당 구성요소와 모델 추론 위치를 설명합니다.
장기 목표는 기억 파일·일정·이벤트로 이어진다
Muse는 사용자가 읽고 편집할 수 있는 기억 파일, 목표와 계획의 진행 상태, 활동 기록을 제공합니다. 장기 작업은 일정과 관련 이벤트에 따라 이어지고, 확인할 만한 변화가 있으면 사용자에게 알리는 방식입니다. 대화가 길어졌다는 사실과 별개로, 목표의 상태와 기억이 다음 작업에 이어지는 구조를 봐야 합니다. 정확한 이벤트 선택·기억 검색 알고리즘 전체가 공개된 것은 아닙니다. Muse의 제품 설계 설명에서 이 동작을 확인할 수 있습니다.
4. OpenClaw: Gateway가 메시지·세션·실행을 연결한다
메신저에서 모델의 도구 호출까지
OpenClaw의 중심은 계속 실행되는 Gateway입니다. Gateway가 메신저 연결을 유지하고, 들어온 요청을 적절한 에이전트와 세션으로 보냅니다. 웹 UI·CLI·앱·장치도 이 제어 계층에 연결됩니다. Gateway 자체가 언어 모델은 아닙니다. 어느 대화의 작업인지 정리하고 실행을 연결하는 서비스입니다.
메시지 한 건의 흐름
메신저·UI의 요청 → Gateway의 세션 연결과 실행 대기열 → 지시·기억·스킬·대화로 입력 구성 → 설정한 모델 런타임 호출 → 도구 실행과 결과 재입력 반복 → 기록 저장과 응답 전송
에이전트 루프는 같은 세션의 실행을 순서대로 처리해 도구 실행과 대화 기록이 서로 꼬이는 일을 줄입니다. 모델이 사용할 문맥을 구성한 뒤, 설정한 모델·런타임을 통해 판단과 도구 호출을 반복합니다. 모델 공급자와 실행 환경은 구성할 수 있으므로 OpenClaw를 하나의 고정 모델 이름처럼 비교하면 안 됩니다. Gateway 아키텍처와 에이전트 루프 문서가 이 흐름을 설명합니다.
기억은 작업 공간의 파일에서 다시 읽는다
기본 작업 공간은 ~/.openclaw/workspace입니다. 현재 문서에서 USER.md는 사용자 선호·지침, MEMORY.md는 오래 유지할 사실·결정, memory/YYYY-MM-DD.md는 날짜별 작업 메모를 맡습니다. 중요한 것은 파일에 남은 정보와 지금 모델에게 주입된 정보가 같지 않을 수 있다는 점입니다.
핵심 기억은 세션 시작에 읽고, 상세 메모는 필요할 때 memory_search·memory_get으로 찾아옵니다. 모든 과거 메모가 매번 통째로 입력되는 것은 아닙니다. 문서의 dreaming sweep은 일별 메모에서 쓸 만한 내용을 추려 장기 기억으로 정리하는 과정이며, 기본 Heartbeat와는 역할이 구분됩니다. OpenClaw 기억 문서에 파일별 용도와 입력 길이 제한이 설명되어 있습니다.
스킬은 별도의 절차 층입니다. SKILL.md에 작업 방법과 도구 사용 지침을 두고 실행에 활용합니다. 현재 문서에는 에이전트가 만든 스킬 초안을 검토하는 Skill Workshop도 있으므로, “OpenClaw에는 기억만 있고 스킬 재사용은 Hermes에만 있다”는 구분은 맞지 않습니다. OpenClaw 스킬 문서.
예약 작업과 Heartbeat가 실행을 깨운다
Automations/cron은 작업 일정을 저장하고 때가 되면 에이전트를 실행하는 기능입니다. “매주 월요일 9시 보고서 작성”처럼 시간을 정한 작업에 해당합니다. Heartbeat는 주기적으로 상황을 확인하는 에이전트 실행이며, 현재 문서에서는 같은 자동화 스케줄러가 관리하는 시스템 자동화로 설명합니다. “주기적으로 확인하다가 의미 있는 변화가 있으면 알려 달라”는 동작을 이해하는 데 적합합니다.
따라서 24시간 작동한다는 표현을 모델이 쉬지 않고 생각한다는 뜻으로 받아들일 필요는 없습니다. 요청이나 예약에 맞춰 실행을 시작할 서비스가 살아 있어야 한다는 뜻입니다. Gateway를 개인 PC에서 돌리면 그 PC의 전원·네트워크에 의존하고, 서버에서 돌리면 서버 운영에 의존합니다. 도구를 실행하는 컴퓨터와 모델 API를 제공하는 서버도 별개일 수 있습니다. 자동화 문서, Heartbeat 문서.
5. Hermes: 실행 루프에 기억·대화 검색·스킬을 결합한다
CLI와 메신저가 같은 실행 핵심을 사용한다
Nous Research의 Hermes Agent도 특정 모델 하나를 뜻하지 않습니다. 모델 공급자와 실행 환경을 연결해 사용하는 에이전트이며, 내부의 AIAgent를 CLI·Gateway·API 등 여러 진입점이 공유합니다. 메신저에서는 Gateway가 발신자 권한과 세션을 확인한 뒤 같은 에이전트 실행 핵심으로 요청을 넘깁니다.
기본 실행 흐름
CLI·Gateway의 요청 → AIAgent가 지시·기억·대화를 구성 → 선택한 모델 API 호출 → 도구 호출을 실행기로 전달 → 결과를 모델에 돌려주며 반복 → 대화 저장과 응답
터미널 도구의 실행 위치도 로컬·컨테이너·원격 환경 등으로 구성할 수 있습니다. 화면이 터미널인지 메신저인지, 명령이 어느 컴퓨터에서 실행되는지, 모델 추론을 어디에 요청하는지는 각각 다른 설정입니다. Hermes 아키텍처, 공식 저장소.
세 종류의 저장소가 서로 다른 일을 한다
- 기억 파일:
~/.hermes/memories/의MEMORY.md와USER.md에 환경 정보·배운 사실·사용자 선호를 간결하게 저장합니다. - 대화 기록: SQLite에 세션을 보관하고,
session_search로 필요한 과거 대화를 찾습니다. 모든 대화를 상시 기억 문단에 넣는 방식이 아닙니다. - 스킬:
~/.hermes/skills/의SKILL.md와 참고 파일에 작업 절차를 저장합니다. 스킬 목록의 정보를 먼저 보고, 필요한 절차와 자료를 단계적으로 불러옵니다.
기억 파일은 세션 시작에 스냅샷으로 시스템 입력에 들어갑니다. 기본 동작에서는 세션 중 기억 도구로 바꾼 내용이 파일에 즉시 저장되지만, 이미 구성한 시스템 입력의 기억 블록은 그 세션 동안 고정됩니다. 도구 응답에는 현재 상태가 나타나고, 다음 세션은 갱신된 파일을 읽습니다. “기억해 뒀다”는 답변만으로 저장이 완료된 것은 아니며, 실제 기억 도구의 쓰기가 일어나야 합니다. Hermes 기억 문서.
경험을 재사용하는 핵심은 절차를 남기는 것이다
예를 들어 문서 변환 중에 특정 옵션이 필요하다는 것을 알아냈다면, 단순히 대화에 남길 수도 있고 다음 변환에 쓸 스킬에 반영할 수도 있습니다. Hermes는 이런 스킬 생성·수정을 지원합니다. 다음에는 관련 스킬을 읽고 검증된 절차를 다시 사용할 수 있습니다. 이때 “학습한다”는 말은 외부 기억과 절차를 축적한다는 의미로 이해해야 합니다. 작업 한 번마다 기반 모델의 가중치가 자동으로 재학습되는 구조를 뜻하지 않습니다. Hermes 스킬 문서.
Hermes에도 Gateway와 cron 예약 실행이 있습니다. 공식 아키텍처의 기본 예약 흐름은 실행 시각이 된 작업을 읽고, 새 에이전트에 프롬프트와 연결된 스킬을 제공해 실행한 뒤 결과를 전달하고 작업 상태를 갱신하는 방식입니다. 예약 실행에 필요한 서비스가 계속 돌아가야 하는 운영 조건도 있습니다. 그러므로 “OpenClaw는 자동화, Hermes는 기억”이라는 양분법보다, 각 시스템에서 실행·저장·재사용을 어떻게 구성하는지 비교하는 편이 정확합니다. Hermes 예약 작업 문서.
6. 실제로 비교할 항목은 무엇인가
네 제품은 상당 부분 같은 일을 할 수 있습니다. 차이는 무엇을 기본 환경으로 제공하고, 어디까지 직접 확인·구성하며, 실행 환경을 누가 운영하느냐에 있습니다.
모바일에서는 표를 좌우로 밀어 볼 수 있습니다.
| 제품 | 실행을 이어 주는 중심 | 기억·절차의 형태 | 사용자가 확인할 운영 지점 |
|---|---|---|---|
| Dots | 관리형 작업 환경, 전용 클라우드 컴퓨터, 위임 작업 | ChatGPT와 공유하는 기억·최근 대화 및 dot의 맥락. 내부 저장·검색 구현 전체는 비공개 | 연결한 서비스, 맡긴 작업의 범위, 자동 검토와 사용자 규칙 |
| Muse | 전용 VM의 Hatch 실행기, 목표·일정·이벤트 | 읽고 편집할 수 있는 기억 파일, 목표 상태와 작업 자료 | Sentinel 승인 정책, 커넥터 권한, 실행 환경과 외부 추론의 경계 |
| OpenClaw | Gateway, 세션별 실행 루프, Automations·Heartbeat | 작업 공간의 Markdown 기억, 상세 메모 검색, SKILL.md | Gateway를 돌릴 호스트, 모델 연결, 채널·도구·샌드박스 설정 |
| Hermes | 공통 AIAgent, CLI·Gateway, cron 작업 | 기억 파일, SQLite 대화 검색, 필요할 때 읽는 스킬 | 실행 프로필, 모델·도구 백엔드, 기억 쓰기와 스킬 갱신, 서비스 운영 |
파일이나 기억 기능이 있다는 사실만으로 개인정보가 모두 로컬에 머무는 것은 아닙니다. 로컬 실행기를 쓰더라도 외부 모델 API를 호출하면 필요한 문맥이 그 API로 전달됩니다. 반대로 클라우드 서비스라고 해서 모든 연결 서비스에 무제한 쓰기 권한을 주는 것도 아닙니다. 실행 위치, 추론 위치, 저장 위치, 행동 권한을 각각 확인해야 합니다.
7. 같은 블로그 업무를 맡기면 구조가 어떻게 드러날까
아래는 공개된 구조를 블로그 업무에 적용한 예시입니다. 실제로 네 제품에 동일한 실험을 수행했다는 뜻은 아닙니다. 자료와 WordPress에 접근할 도구가 준비되어 있고, 초안 작성·게시의 허용 범위를 사용자가 정했다는 조건입니다.
- 일을 시작한다. Dots·Muse에서는 지원되는 지속 작업이나 일정 기능에 목표를 맡깁니다. OpenClaw·Hermes에서는 Gateway와 예약 실행 서비스가 동작하도록 구성하고 작업을 등록합니다.
- 지난 기준을 불러온다. 문체·카테고리·제외할 출처 같은 정보를 기억이나 프로젝트 지침에서 가져옵니다. 게시 절차와 썸네일 확인 순서는 스킬 또는 재사용할 작업 지침으로 둡니다.
- 자료를 조사하고 초안을 만든다. 모델은 검색·브라우저·파일 도구를 호출하고 결과를 읽습니다. 근거가 부족하거나 이미지가 빠졌다면 추가 작업을 선택합니다. 실행 기록에는 이런 과정이 남아야 합니다.
- 승인된 범위에서 게시한다. 원고가 완성됐다는 판단과 공개 게시 권한은 별개입니다. Dots·Muse의 제품 권한 체계 또는 직접 구성한 도구 권한·승인 절차에 따라 실제 쓰기 요청이 실행됩니다.
- 결과를 확인하고 다음 작업에 남긴다. 게시 API의 응답뿐 아니라 공개 URL의 본문·이미지·썸네일을 확인합니다. 검증된 처리 방법과 수정 사항을 저장해야 다음 실행에서 재사용할 수 있습니다.
이 흐름에서 “완료”라는 문장이 출력됐다는 사실은 약한 증거입니다. 조사 결과가 근거와 맞는지, 파일과 게시물이 실제로 만들어졌는지, 기억 쓰기와 예약 등록이 성공했는지까지 확인해야 합니다. 이 기준으로 보면 에이전트의 가치는 말투보다 여러 실행에 걸쳐 작업 상태를 정확하게 이어 가는 능력에서 드러납니다.
8. 어떤 구조가 내 작업에 맞는가
Dots와 Muse를 검토할 때는 이미 제공되는 클라우드 작업 환경에서 필요한 서비스에 접근할 수 있는지, 장기 작업과 승인 과정을 충분히 확인·수정할 수 있는지를 보면 됩니다. OpenClaw와 Hermes를 검토할 때는 모델·실행 위치·기억 파일·스킬을 직접 구성할 자유와 함께, 서비스 유지·업데이트·권한 설정을 누가 맡을지까지 봐야 합니다.
OpenClaw 안에서는 Gateway의 채널·세션 라우팅과 자동화 운영이 내 환경에 맞는지, Hermes 안에서는 공통 실행 루프에 연결된 기억·과거 대화 검색·스킬 재사용이 내 작업 방식에 맞는지 살펴볼 수 있습니다. 이는 기능 독점이나 우열을 뜻하지 않습니다. 두 프로젝트 모두 계속 확장되므로 실제 선택에서는 같은 작업·모델·권한 조건을 놓고 실행 기록과 실패 복구 과정을 비교해야 합니다.
개인 에이전트를 고른다는 것은 모델 이름 하나를 고르는 일보다 넓습니다. 판단할 모델, 행동할 도구, 이어 갈 기억, 다시 실행할 일정, 행동을 제한할 권한을 하나의 작업 흐름으로 선택하는 일입니다.
답글 남기기